

Rozdział empiryczny pracy magisterskiej jest tym miejscem, w którym deklaracje metodologiczne zderzają się z rzeczywistością zebranych danych. Problem badawczy, przed którym staje większość magistrantów, nie polega na braku dostępu do narzędzi obliczeniowych, lecz na trafnym dopasowaniu procedury analitycznej do postawionych hipotez i do charakteru zmiennych. Literatura przedmiotu konsekwentnie wskazuje, że dobór metod statystycznych powinien wynikać z celu badania, rodzaju zmiennych, pytań badawczych i hipotez, a testów nie należy wybierać przypadkowo ani wyłącznie z powodu ich popularności. Ten tekst porządkuje kolejne etapy pracy z danymi: od operacjonalizacji zmiennych i doboru próby, przez statystykę opisową, aż po testy istotności i sposób raportowania wyników.
Statystyka nie jest obowiązkowym dodatkiem do każdej pracy dyplomowej. Jej zastosowanie ma sens wtedy, gdy problem badawczy został sformułowany w kategoriach ilościowych — czyli wtedy, gdy pytamy o częstość, natężenie, różnicę między grupami albo o współwystępowanie cech. Jeżeli badanie polega na analizie grup osób, porównaniu zmiennych lub sprawdzeniu zależności między czynnikami, metody statystyczne stają się niezbędne, ponieważ pozwalają przeanalizować dane rzetelnie i obiektywnie.
Warto zaznaczyć, że nadmiar analiz bywa równie szkodliwy jak ich brak. Nie każda praca wymaga wielu testów — czasami wystarczy dobrze wykonana analiza opisowa i kilka testów odpowiadających hipotezom, a ważniejsza od liczby analiz jest ich poprawność. W praktyce recenzenci znacznie surowiej oceniają błędne zastosowanie zaawansowanej procedury niż skromny, ale spójny zestaw prostych narzędzi.
Konsekwencje metodologicznych zaniedbań są wymierne. Jak podkreślają praktycy zajmujący się opracowaniem badań w pracach magisterskich, wiele prac otrzymuje niższe oceny właśnie z powodu nieprawidłowego opisu statystycznego badań, a błędnie wykonana statystyka zniekształca wyciągane wnioski.
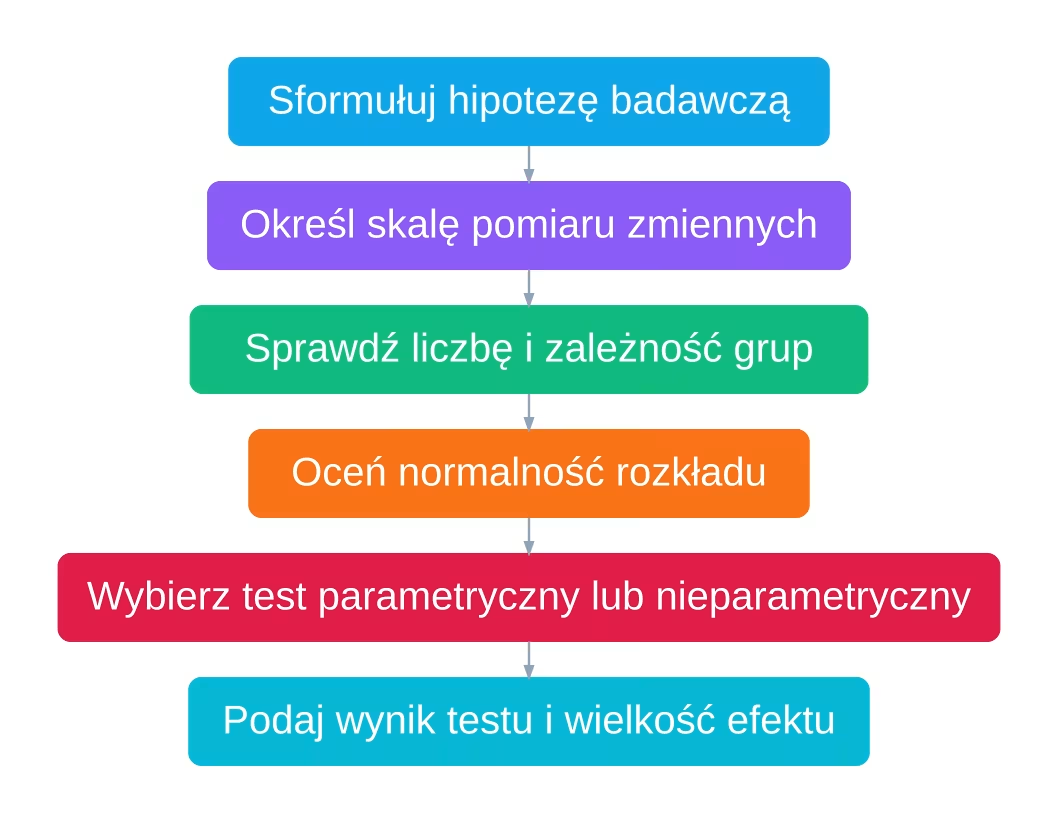
Zanim padnie pytanie o konkretny test, trzeba rozstrzygnąć, w jakiej skali mierzone są zmienne. To rozstrzygnięcie determinuje wszystko, co nastąpi później. Nieprawidłowe określenie skali pomiarowej zmiennych jest jednym z najczęstszych błędów w analizach do prac dyplomowych i prowadzi do złego doboru testów, nawet gdy ogólny schemat analizy wygląda poprawnie.
Klasyczna typologia Stevensa wyróżnia cztery poziomy pomiaru. Skala nominalna to etykiety bez hierarchii, skala porządkowa oznacza kolejność bez równych odstępów, skala przedziałowa ma równe odstępy przy umownym zerze, a skala ilorazowa dysponuje zerem absolutnym i pozwala interpretować ilorazy. Praktyczne rozróżnienie widać w typowej ankiecie: wybór rodzaju placówki gastronomicznej to zmienna nominalna, natomiast ocena wpływu czynnika w skali od 1 do 5 czy poziom wykształcenia to zmienne porządkowe.
Znaczenie tego rozróżnienia dla całej pracy jest fundamentalne — dobór skali decyduje o tym, jakie testy statystyczne są dopuszczalne, a zła skala oznacza złe testy i błędne wnioski, niezależnie od doświadczenia analityka. Dobrym przykładem zastosowania tej zasady w badaniach konsumenckich jest opracowanie o wykorzystaniu testu chi-kwadrat w badaniach preferencji, które pokazuje krok po kroku, jak dobrać test do rodzaju zmiennych.
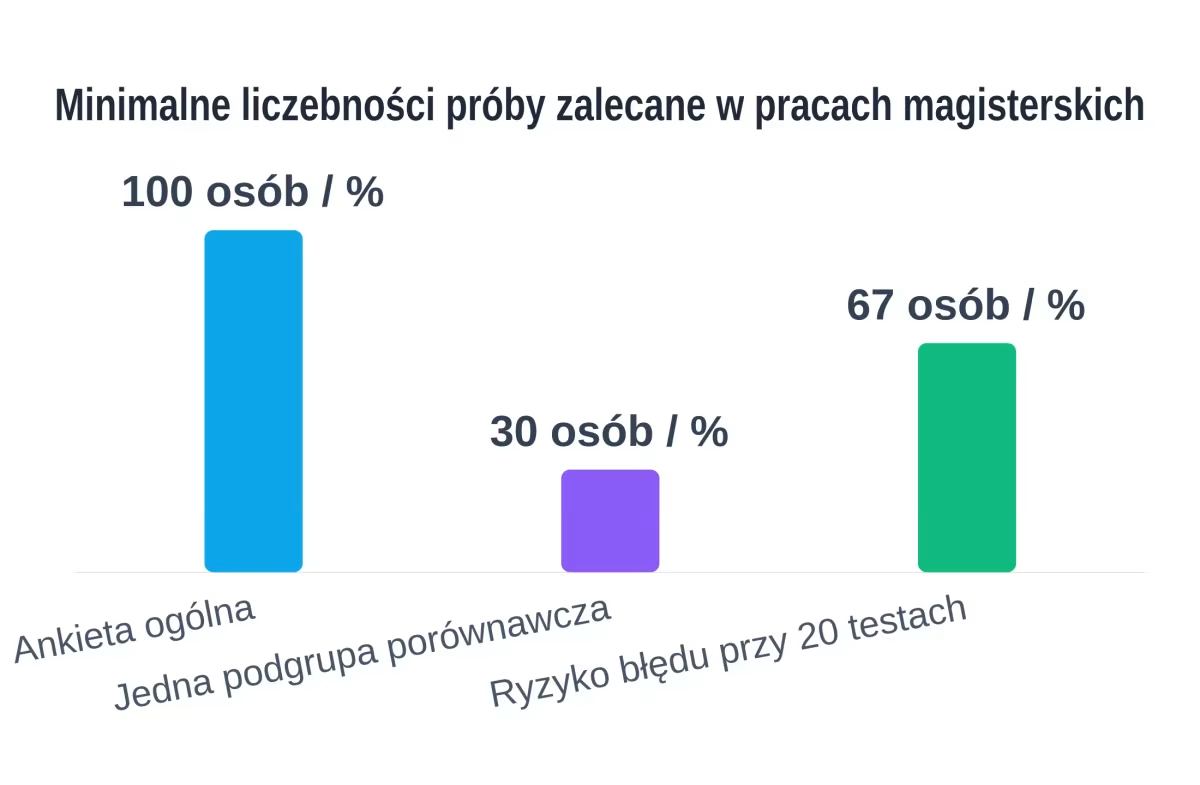
Kwestia liczebności próby wymaga osobnego komentarza. Nie istnieje magiczna liczba respondentów gwarantująca istotność — każdy efekt, niezależnie od tego, jak byłby niewielki, może wygenerować małe p-value, jeżeli liczebność próby lub precyzja pomiarów są wystarczająco duże. W pracach magisterskich opartych na ankiecie za praktyczne minimum przyjmuje się zwykle 100 obserwacji, a przy planowanym podziale na podgrupy — co najmniej 30 osób w każdej z nich. Kluczowe jest też uczciwe opisanie sposobu doboru: czy była to próba losowa, kwotowa, czy raczej dobór celowy lub dostępnościowy, co ogranicza możliwość uogólniania wyników na populację.
Analiza opisowa porządkuje materiał, zanim zaczniemy cokolwiek testować. Dla zmiennych ilościowych raportuje się miary tendencji centralnej i rozproszenia: średnią arytmetyczną, medianę, dominantę, odchylenie standardowe, wariancję oraz rozstęp. Dla zmiennych jakościowych podaje się liczności i odsetki. Zasada jest prosta i wynika wprost z poziomu pomiaru: dla skali nominalnej nie liczymy średnich, lecz modę i chi-kwadrat, a dla porządkowej używamy mediany i testów nieparametrycznych.
Trzeba pamiętać, jak działają poszczególne miary. Rozstęp bywa mylnie zaliczany do miar tendencji centralnej — jest to twierdzenie fałszywe, rozstęp opisuje bowiem zmienność. Warto też podać wartości skrajne, ponieważ pojedyncze obserwacje odstające potrafią radykalnie przesunąć średnią, podczas gdy mediana pozostaje odporna.
Ostatni punkt bywa pomijany, choć decyduje o dalszym postępowaniu. W praktyce analitycznej, gdy rozkłady odbiegają od normalnego, do dalszych analiz wybiera się metody nieparametryczne. Więcej praktycznych wskazówek dotyczących całego bloku obliczeniowego znajdziesz w naszym omówieniu na temat statystyki do pracy magisterskiej.
Etap wnioskowania statystycznego polega na przenoszeniu wniosków z próby na populację. Logika testowania jest zawsze taka sama: formułujemy hipotezę zerową o braku różnicy lub braku związku, a następnie sprawdzamy prawdopodobieństwo uzyskania takich danych przy jej prawdziwości. Jeżeli wartość p jest mniejsza niż 0,05, odrzucamy hipotezę zerową i uznajemy wynik za istotny statystycznie.
Dobór testu zależy od skali pomiaru, liczby porównywanych grup i tego, czy grupy są zależne. Dla skali nominalnej stosuje się test chi-kwadrat, a gdy warunek Cochrana nie jest spełniony — test dokładny Fishera lub, w tabelach 2×2 o próbie większej niż 40, poprawkę Yatesa; dla skali porządkowej stosuje się test chi-kwadrat dla trendu. Warunki stosowania testu chi-kwadrat są przy tym jasne: wymaga on dwóch zmiennych jakościowych — mogą to być dwie zmienne nominalne, dwie porządkowe albo typy mieszane.
Sama istotność to jednak za mało. Standardy raportowania są tu jednoznaczne: podawanie wielkości efektu jest wymagane przez standard APA, ponieważ p-value pozwala jedynie zweryfikować hipotezę, a istotność statystyczna nie jest tożsama z istotnością praktyczną. Przegląd najczęściej stosowanych miar zawiera opracowanie omawiające wskaźniki wielkości efektu w badaniach psychologicznych. Rzetelny raport powinien zawierać dokładną wartość p, odpowiednią statystykę testową, stopnie swobody oraz właściwe statystyki opisowe.
Osobną pułapką jest testowanie wielokrotne. Przyjmując poziom 0,05, godzimy się na błąd średnio raz na dwadzieścia decyzji, a przy dwudziestu niezależnych testach prawdopodobieństwo popełnienia błędu przynajmniej raz przekracza dwie trzecie. Wniosek dla magistranta jest praktyczny: lepiej przetestować pięć hipotez wynikających z teorii niż czterdzieści zależności wygenerowanych metodą prób i błędów. Zagadnienie to szerzej omawia artykuł Rozważania o p-value opublikowany w zeszytach naukowych.
Wybór narzędzia jest wtórny wobec poprawności metodologicznej, ale wpływa na tempo pracy i sposób raportowania. Praktyka akademicka wskazuje, że metody analizy dobiera się zgodnie z celami badawczymi, wykorzystując programy statystyczne takie jak Statistica, R czy SPSS.
Jeśli myślisz o rozwijaniu badań poza magisterium, warto od razu przyjąć dyscyplinę dokumentowania obliczeń: zapisywać wersje danych, skrypty i parametry testów. Tę samą zasadę opisujemy w tekście o pisaniu pracy doktorskiej krok po kroku, gdzie powtarzalność analiz decyduje o wiarygodności całej rozprawy.
Częstym mankamentem rozdziałów badawczych jest sprowadzenie ich do galerii wykresów kołowych. Tymczasem nie należy ograniczać się wyłącznie do wykresów, ponieważ w pracy dyplomowej potrzebna jest również interpretacja statystyczna. Każdy element graficzny wymaga numeracji, tytułu, źródła oraz komentarza w tekście głównym.
Kluczowe jest też rozdzielenie warstwy metodologicznej od warstwy wynikowej. W metodach opisujesz plan i sposób analizy, a w wynikach pokazujesz rezultat — w metodach napiszesz, że do sprawdzenia zależności zastosowano korelację Spearmana, a w wynikach podajesz wartość współczynnika, poziom istotności i interpretację. Pomocna okazuje się prosta konwencja redakcyjna: stosowanie schematu „Do weryfikacji hipotezy H1 zastosowano…”, „W celu sprawdzenia zależności między…”, „Do porównania grup wykorzystano…” sprawia, że promotor widzi, iż każda analiza ma swoje miejsce.
Sformułowania typu „dane przeanalizowano statystycznie” są w tym kontekście bezużyteczne — to zbyt ogólny opis, lepiej wskazać konkretnie, jakie analizy wykonano i po co. Ustalając terminologię, sięgnij po definicje przyjęte w statystyce publicznej; ich kompletny zbiór stanowią pojęcia stosowane w statystyce publicznej udostępniane przez GUS. Ogólne zasady metodologiczne i definicje obowiązujące w badaniach statystyki publicznej ustala zarządzeniem Prezes GUS, co czyni je wygodnym punktem odniesienia.
Decyduje sekwencja trzech pytań: jaka jest skala pomiaru zmiennych, ile grup porównujemy i czy grupy są niezależne. Zgodnie z zaleceniem metodologicznym najpierw formułujemy pytanie lub hipotezę, potem określamy zmienne, a dopiero na końcu wybieramy metodę — taki układ chroni przed sytuacją, w której w metodologii pojawia się pięć testów, ale nie wiadomo, który do czego służy.
Analiza opisowa charakteryzuje wyłącznie zbadaną próbę: podaje rozkłady, średnie i odchylenia. Wnioskowanie statystyczne pozwala natomiast szacować, na ile zaobserwowane prawidłowości można przenieść na populację. Trzeba przy tym zachować ostrożność interpretacyjną, bo obliczona wartość p odnosi się jedynie do wyniku pojedynczej próby, a test statystyczny nie przekształca niepewności wnioskowania w pewność co do prawdziwości hipotezy. Analizę ankiet dzieli się zwykle na te dwa główne etapy.
Liczebność wynika z celu badania, liczby analizowanych podgrup i oczekiwanej wielkości efektu, a nie z uczelnianej tradycji. Przy słabych efektach próba musi być większa, przy silnych — mniejsza. Konsekwencje pomijania tej zależności są istotne, ponieważ sztywne progi powodują, że część wartościowych badań, w których wielkość efektu okazała się za mała, bywa porzucana, a ich wyniki opatruje się nieprawdziwą konkluzją o braku różnicy. Praktyczne minimum dla ankiety magisterskiej to zwykle 100 respondentów, przy analizach porównawczych — co najmniej 30 osób w każdej porównywanej podgrupie.
Jeśli praca ogranicza się do statystyki opisowej i kilku prostych testów, wystarczy arkusz kalkulacyjny. Przy testach nieparametrycznych, analizie wariancji, regresji czy analizie rzetelności skal właściwym wyborem jest SPSS, R lub Statistica. Kryterium praktyczne jest jedno: narzędzie, do którego masz dostęp i którego wyniki potrafisz samodzielnie zinterpretować podczas obrony.
Tak, przy zachowaniu przejrzystości. Korzystanie z takiej pomocy jest dopuszczalne, a w przypadku prac dyplomowych i doktoratów przyjęło się ujawniać udział statystyka w podziękowaniach, wraz z określeniem zakresu jego wsparcia. Nie zwalnia to jednak autora z obowiązku rozumienia własnych wyników — komisja egzaminacyjna pyta o interpretację, nie o obsługę oprogramowania.
Poprawnie zaprojektowana część statystyczna pracy magisterskiej opiera się na kilku prostych zasadach: skala pomiaru wyznacza dopuszczalne testy, hipoteza determinuje procedurę, a każdy wynik wymaga interpretacji merytorycznej uzupełnionej o miarę siły efektu. Poprawna analiza statystyczna obejmuje kilka etapów, których zakres zależy od tematu pracy, rodzaju danych, liczby respondentów, hipotez oraz wymagań promotora. Świadome przejście przez te etapy — zamiast mnożenia obliczeń — jest tym, co odróżnia rozdział empiryczny obroniony z wysoką oceną od zbioru przypadkowych wykresów.
Serwis korzysta z cookies do anonimowych statystyk odwiedzin. Uruchamiamy je wyłącznie po Twojej zgodzie. Szczegóły znajdziesz w polityce prywatności.